검색창 하나에 담긴 기술
자동완성부터 초성 검색까지, 검색창 뒤의 일들
1. 한 글자 칠 때마다 일어나는 일
쇼핑몰 검색창에 '운동'까지만 쳐도 운동화, 운동복, 운동화 끈이 아래로 주르륵 펼쳐집니다. 별것 아닌 듯 보여도 그 뒤에서는 글자 하나가 입력될 때마다 서버로 질문이 날아갑니다. 수많은 상품 이름 중에서 앞부분이 맞는 것을 찾고, 많이 찾는 순서로 줄 세운 다음, 다음 글자가 들어오기 전에 화면으로 돌려보내는 거죠. 오타도 알아서 봐줍니다. 검색 서비스 알골리아(Algolia)는 기본 설정에서 네 글자 이상인 단어는 오타 하나, 여덟 글자 이상이면 오타 두 개까지 허용합니다. 'iphnoe'라고 잘못 쳐도 아이폰이 나오는 이유입니다. 사용자는 그냥 잘 찾아진다고 느끼지만, 그 짧은 순간에 꽤 많은 계산이 들어 있습니다.
2. 한국어 검색이 유독 까다로운 이유
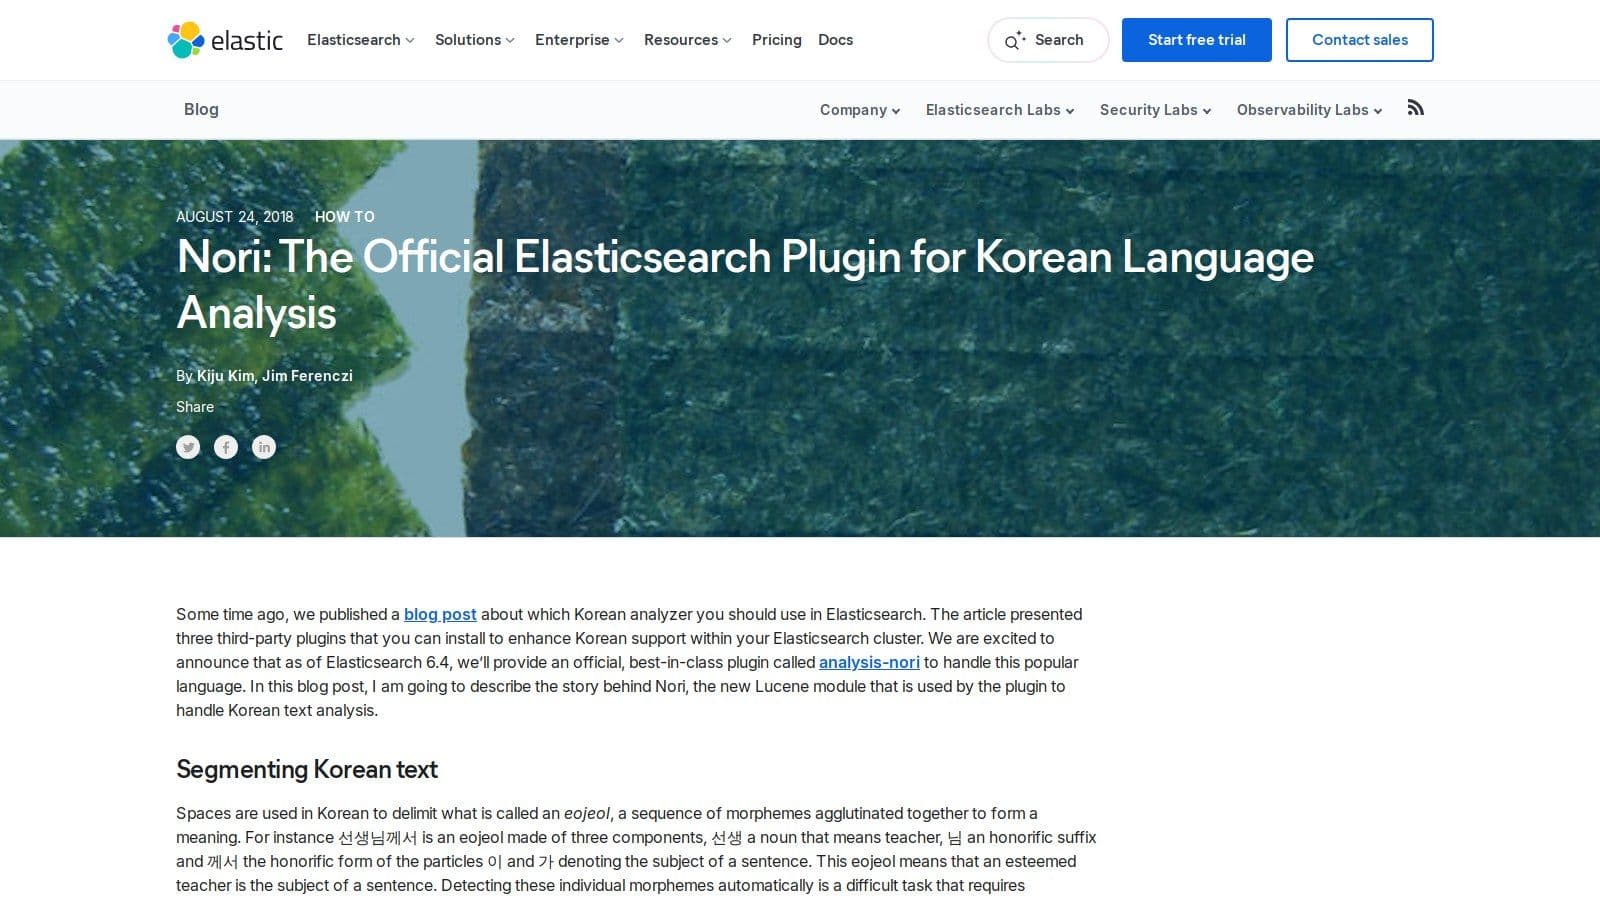
영어는 띄어쓰기만으로도 단어를 꽤 잘 나누지만 한국어는 다릅니다. '선생님께서'라는 한 덩어리 안에 선생, 님, 께서가 붙어 있으니까요. 엘라스틱서치가 공식 한국어 분석기 노리(Nori)를 소개하면서 든 예시인데, 6.4 버전부터 제공된 노리는 mecab-ko-dic 사전으로 이렇게 붙은 말을 형태소 단위로 쪼갭니다. '도서관'을 '도서'와 '관'으로 나눠 두면 도서를 검색한 사람에게도 결과를 보여줄 수 있죠. 띄어쓰기도 골칫거리입니다. '세컨드 펭귄'이라고 쳤는데 저장된 이름이 '세컨드펭귄'이면 단순한 검색은 아무것도 찾지 못합니다. 메일리서치(Meilisearch) 같은 오픈소스 엔진이 한국어 사전을 따로 붙여 두는 것도 이 때문입니다.
3. 초성만 쳐도, 한영 키를 깜빡해도
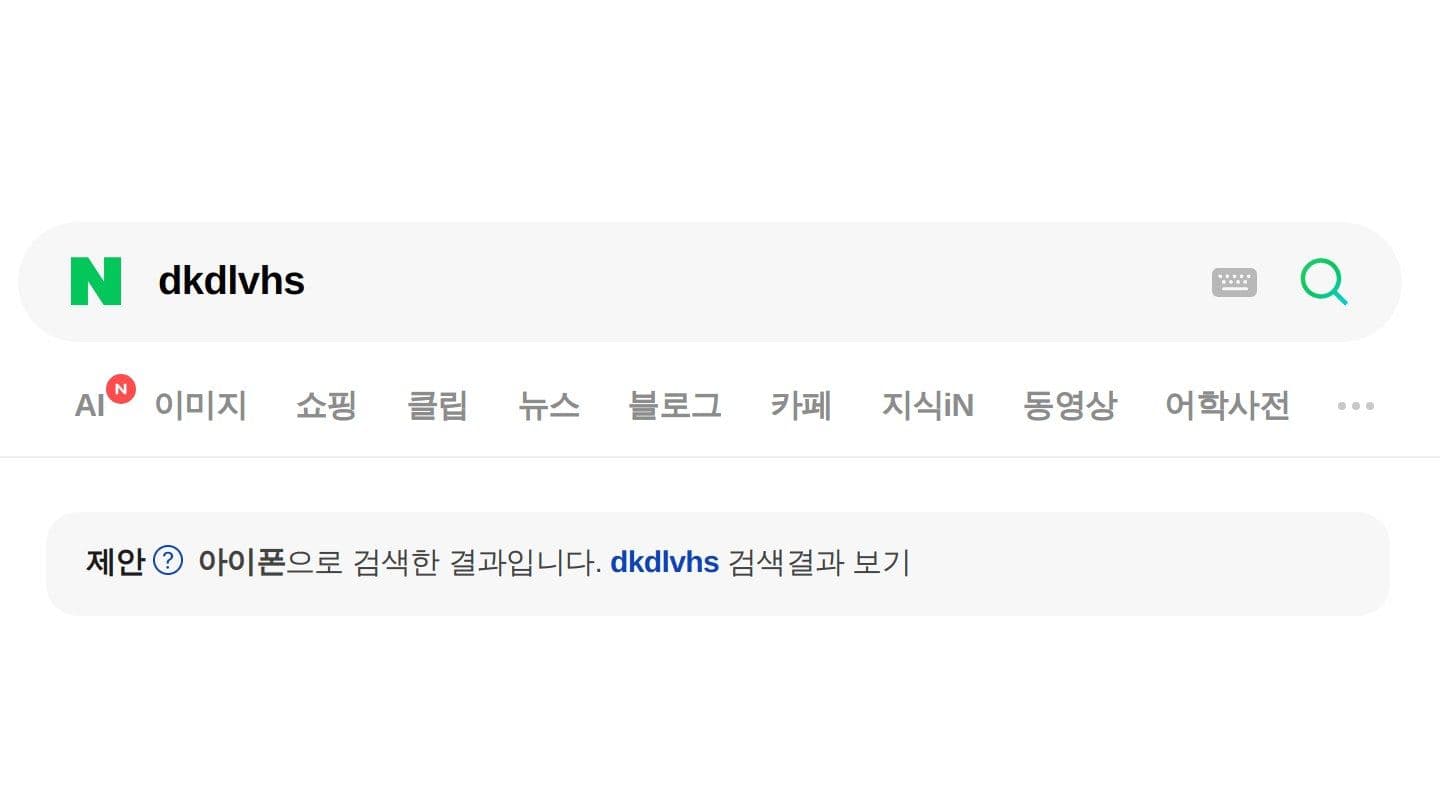
한국어 사용자에게만 있는 습관도 있습니다. 연락처에서 'ㄱㅅㅎ'만 쳐서 김세훈을 찾는 초성 검색이 대표적이죠. 계산은 어렵지 않습니다. 유니코드에는 완성형 한글 11,172자가 '가'(U+AC00)부터 순서대로 놓여 있고, 초성 하나마다 중성과 종성 조합 588개가 묶여 있습니다. 글자 코드에서 '가'를 빼고 588로 나눈 몫이 초성 번호입니다. 저장할 때 초성만 뽑아 둔 칸을 하나 더 만들어 두면 됩니다. 한영 전환을 잊고 친 'dkdlvhs'를 아이폰으로 바꿔 주는 것도 비슷한 아이디어로, 자판 위치를 그대로 한글로 옮겨 보는 겁니다. 네이버는 이걸 알아서 해 주지만, 해외 검색 도구에는 대개 없는 기능이라 직접 만들어 넣어야 합니다.
4. 세컨드펭귄의 시선: 결과가 없을 때의 화면부터 챙깁니다
검색 기능을 만들 때 우리가 가장 오래 붙잡는 화면은 의외로 결과가 없는 페이지입니다. '검색 결과가 없습니다' 한 줄로 끝내면 사용자는 거기서 떠나니까요. 바꿔 볼 만한 검색어, 많이 찾는 검색어, 비슷한 카테고리로 가는 길, 문의 버튼까지 두려고 합니다. 결과가 0건이었던 검색어를 모아 두면 사람들이 무엇을 찾다 실패했는지도 보이고요. 도구는 규모에 맞게 고릅니다. 글이 수백 개인 사이트라면 Strapi 콘텐츠를 Docker로 띄운 Meilisearch에 연결하는 정도면 충분하고, 상품이 많고 트래픽이 크다면 Elasticsearch나 Algolia도 함께 검토합니다.